Interesting Engineering · 原标题:Humanoid robots trained on 1M hours of human video achieve up to 90% task success
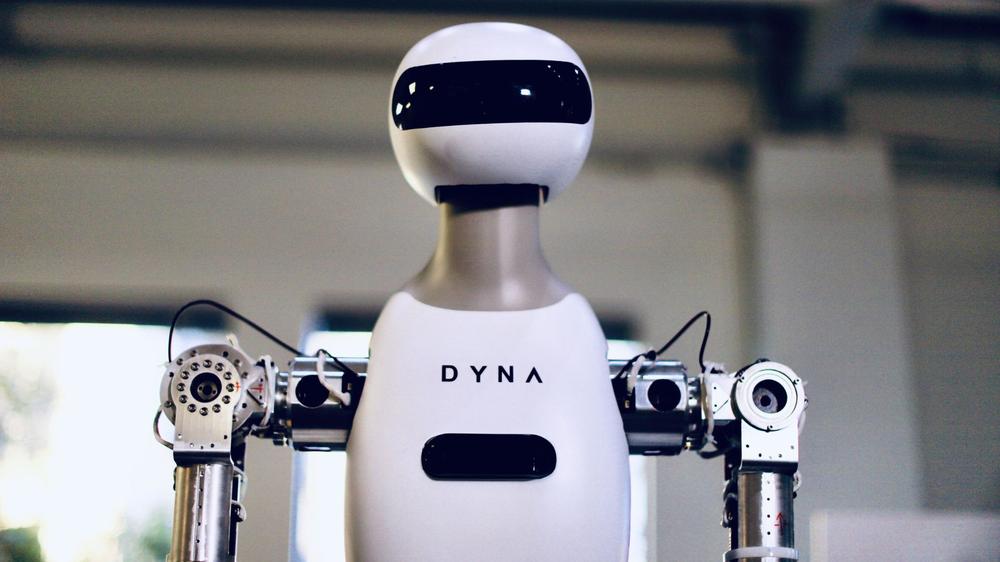
Dyna Robotics 发布了一款新的机器人基础模型,该模型基于超过100万小时的人类视频数据进行训练。借助大规模视频学习,人形机器人在多项任务上的成功率最高达到90%,展示了利用人类视频数据提升机器人策略泛化能力的潜力。
Dyna Robotics 发布了一款新的机器人基础模型,该模型基于超过100万小时的人类视频数据进行训练。借助大规模视频学习,人形机器人在多项任务上的成功率最高达到90%,展示了利用人类视频数据提升机器人策略泛化能力的潜力。
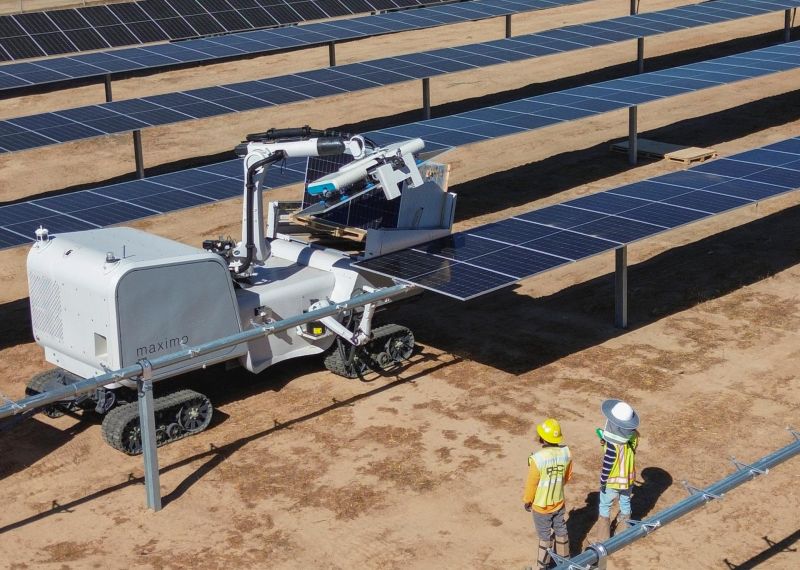
当前关于具身智能的讨论多集中于从原型走向商用部署的技术,而全球能源公司 AES 已将机器人应用于公用事业级太阳能电站建设。其开发的 AI 驱动机器人系统 Maximo 可自动化太阳能施工中最耗费体力的组件搬运环节,目前已完成超过18万块太阳能板的安装。
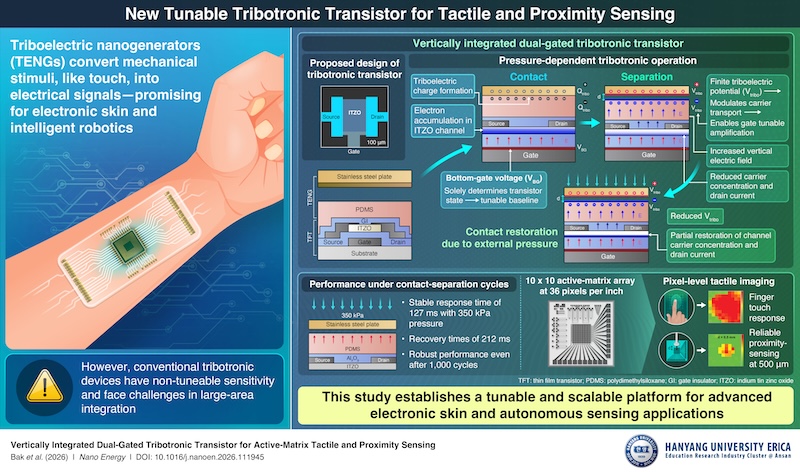
汉阳大学 ERICA 校区的研究人员开发出一种垂直集成的双栅晶体管设计,可为机器人提供可靠的触觉感知以及高密度、大面积集成能力。传统摩擦电子器件灵敏度固定、难以大面积集成,新设计有望克服这些局限,推动电子皮肤在机器人与假肢上的应用。
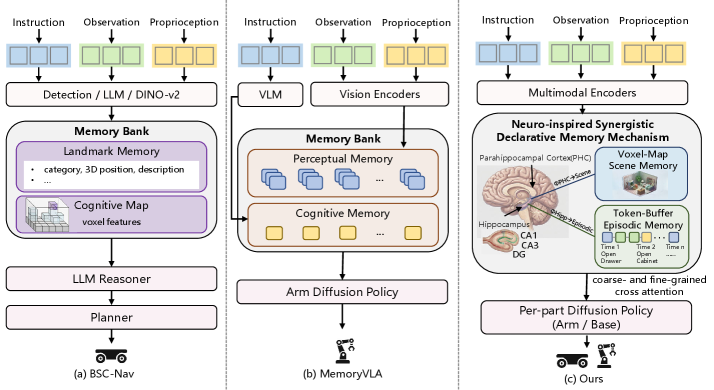
VLA 模型的最新进展使具身智能体能够理解多模态指令并执行复杂任务,但现有 VLA 多局限于短时程桌面操作,缺乏移动操作所需的记忆与推理能力。EchoVLA 是一种具备记忆感知能力的 VLA 模型,通过协同陈述性记忆,使智能体能够在变化的空间环境中协调导航与操作。