EchoVLA:面向移动操作、具备协同陈述性记忆的机器人视觉-语言-动作模型
原标题:EchoVLA: Robotic Vision-Language-Action Model with Synergistic Declarative Memory for Mobile Manipulation
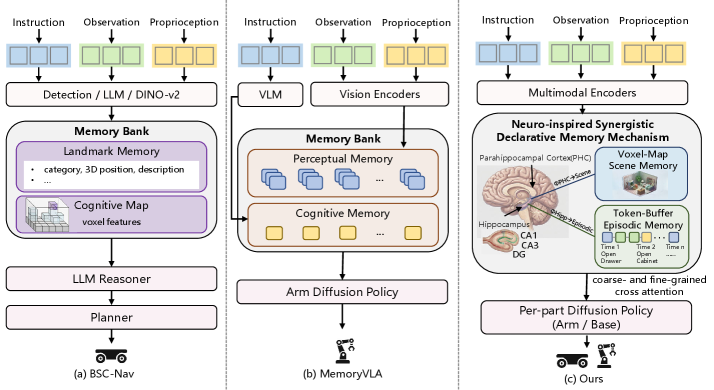
arXiv:2511.18112v3 公告类型:替换(replace) 摘要:视觉-语言-动作(VLA)模型的最新进展使具身智能体能够解读多模态指令并执行复杂任务。然而,现有的 VLA 大多局限于短周期、桌面级操作,缺乏移动操作所需的记忆与推理能力——在移动操作中,智能体必须在不断变化的空间环境下协调导航与操作。在本工作中,我们提出 EchoVLA,一个面向移动操作的记忆感知型 VLA 模型。EchoVLA 引入了受人类大脑启发的协同陈述性记忆,由两部分组成:一是场景记忆(scene memory),用于维护一组空间-语义地图;二是情节记忆(episodic memory),用于存储带有多模态上下文特征的任务级经验。这两种记忆分别存储、更新,并基于当前观测、任务历史和指令进行检索;检索到的表征通过粗粒度与细粒度注意力进行融合,以指导基座-机械臂(base-arm)扩散策略。为支持大规模训练,我们进一步提出 MoMani,一个自动化基准,它通过多模态大语言模型(MLLM)引导的规划与反馈驱动的改进来生成专家级轨迹,并以真实机器人演示作为补充。全面的仿真与真实世界实验结果表明,EchoVLA 显著提升了整体性能,例如,它在仿真中的操作/导航任务上取得 0.52 的最高成功率,在移动操作任务上取得 0.31 的最高成功率,分别超过强基线 $\pi_{0.5}$ +0.20 和 +0.11。