基于100万小时人类视频训练的人形机器人,任务成功率最高达90%
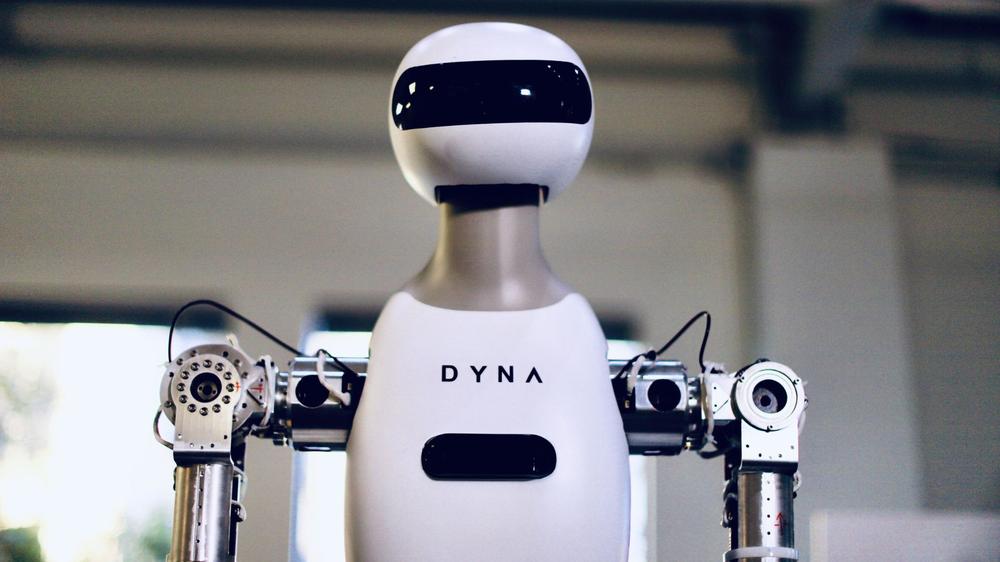
Dyna Robotics 发布了一款基于超过100万小时人类视频训练的新型机器人基础模型,该公司表示,这一规模有望帮助攻克教机器人完成物理任务时面临的最大挑战之一。这家总部位于加利福尼亚州 Redwood City 的公司称,其 DYNA-2 World-Action Model 完全基于人类第一人称视角视频训练,而非机器人动作数据。该数据集相当于约170年不间断的清醒体验。该方法旨在让机器人从人类与物体及周围环境的交互方式中学习物理技能,从而减少对人工采集遥操作数据的依赖。Dyna 表示,随着机器人能力的扩展,这可以提供一种更具可扩展性的机器人训练方式。在测试中,该公司报告称,仅通过扩大预训练规模,DYNA-2 就将高精度制造任务的成功率从20%提升至80%-90%。该模型还展示了在固定式机械臂、人形机器人原型和灵巧手之间的迁移能力。
人类视频成为训练数据 Dyna 的模型采用了一种结合下一帧预测和下一动作预测的世界模型架构。该系统并非仅从机器人执行的动作中学习,而是利用人类视频来理解物理环境如何变化以及物体如何响应运动。该公司表示,这使得从人类行为中获得的知识能够迁移到不同的机器人硬件上。Dyna 称,DYNA-2 在预训练期间从未见过机器人数据,但之后只需几个小时的本地微调即可适配不同平台。在一项测试中,仅用13分钟的数据,DYNA-2 就能够指挥一对五指灵巧手拧开瓶盖。在15项基准任务中,Dyna 表示,使用更多人类视频训练的模型表现始终更好。该公司还将 DYNA-2 与采用视觉-语言-动作架构的早期模型 DYNA-1 进行了对比。在一次零样本客户部署中,DYNA-2 的质量合格率达到87%,而 DYNA-1 仅为46%。
超越遥操作的机器人规模化 Dyna 表示,当物理干扰打断任务时,该模型还展现出更强的韧性。在涉及切菜和清理工作台面等活动的测试中,DYNA-2 无需人工干预即可自行恢复,而早期模型则需要人工恢复。该公司表示,其视频协同训练方法在指令遵循任务上将得分提高了133%,这类任务要求机器人根据指令执行不同的物理动作。
"多年来,通用机器人一直受制于数据瓶颈:人工采集物理遥操作数据的方式根本无法扩展到通用智能,"Dyna Robotics 联合创始人 Jason Ma 表示。"动作数据稀缺,但视频无处不在。通过 DYNA-2,我们证明了物理直觉并不需要在机械臂上进行数百万小时的训练——它可以直接从人类视频中习得。"
Dyna Robotics 表示,搭载上一代 DYNA-1 模型的机器人已在酒店、餐厅和自助洗衣店部署。该公司将 DYNA-2 视为迈向让机器人能够在无需大量机器人专属训练数据的情况下学习新物理任务的一步。该公司由 Lindon Gao、York Yang 和前 DeepMind 研究科学家 Jason Ma 共同创立,投资方包括 CRV 和 First Round 等。