AI 时代重新思考机器人安全:Physical AI 的网络攻击面
原标题:Rethinking Robot Safety in the Age of AI
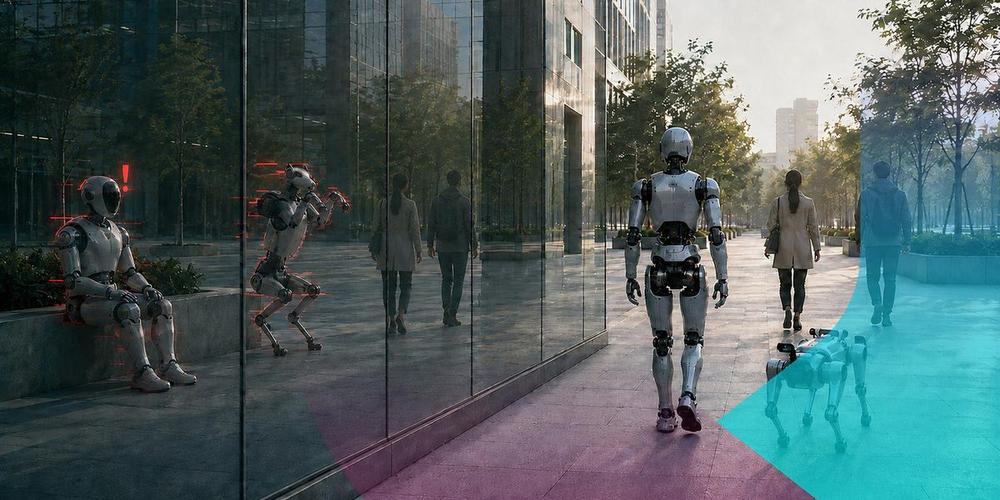
传统机器人安全问的是:当机器出现故障时,它能否保持安全?Physical AI 提出了一个更难的问题:当攻击者改变了机器人看到、决定或执行的内容,而系统表面上毫无异常时,它还能否保持安全?
随着 AI 与机器人以空前的速度发展,现代机器人通过多模态传感器感知世界,用 AI 模型理解上下文,并将这些理解转化为物理动作。当它们进入动态环境,安全性越来越依赖于指导其决策的数据完整性。这种依赖带来了传统安全评估可能无法完全捕捉的风险。
近期研究表明,操控机器人看到、听到或解释的内容,可以在不需要直接控制的情况下影响其行为。这种操控可能发生在复杂感知与决策系统的任何环节——一个涵盖训练 pipeline、系统基础设施和运行时感知的多层攻击面。
文章从三个层面展开分析:
第一层:从源头腐蚀智能。2017 年的 BadNets 证明,模型在大多数情况下表现正常,但在特定隐藏触发器存在时会失效。例如,一个 subtle 图案会让停车标志被误识别为限速标志,而不影响其他输入。这种分类漏洞已演变为动作操控。NeurIPS 2025 上,研究者提出 BadVLA,一种针对 Vision-Language-Action(VLA)模型的后门攻击,可在触发器存在时导致机器人动作轨迹产生条件性偏离。
第二层:基础设施攻击。训练数据、模型仓库、更新机制都可能成为攻击入口。
第三层:运行时感知操控。对抗样本可直接欺骗传感器或视觉模型,让机器人在真实环境中做出错误动作。
文章强调,机器人安全标准需要把"数据完整性"与"AI 决策可验证性"纳入核心,而不仅仅是机械冗余。