ADEPT:用预训练+后训练强化学习加速机器人灵巧操作
原标题:ADEPT: Accelerating Dexterity via Pre-Training and Post-Training using Reinforcement Learning
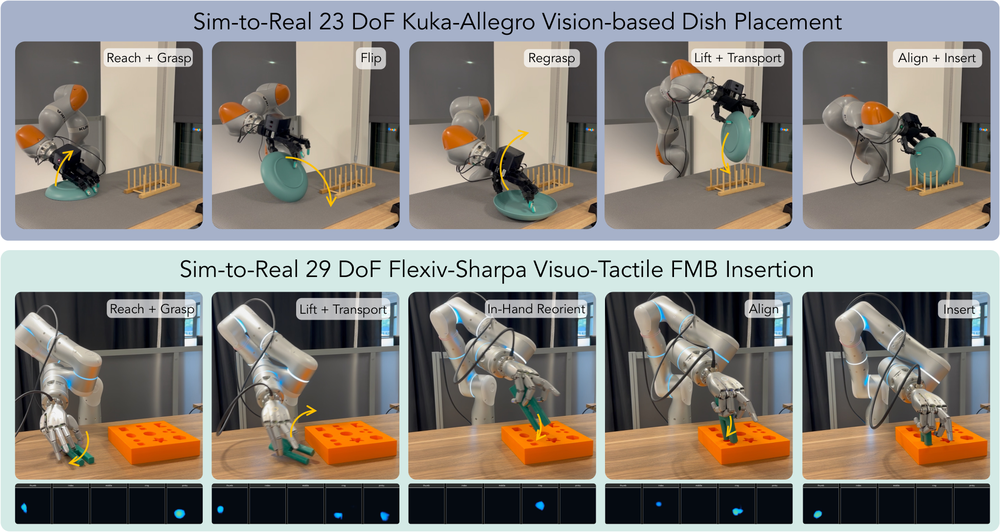
研究者提出 ADEPT(Accelerating Dexterity via Pre-Training,通过预训练加速灵巧性),一个大规模强化学习(RL)框架,用于学习可在仿真到现实(sim-to-real)之间迁移的灵巧操作。
ADEPT 面向高自由度(DoF)机器人本体,能够直接从原始视觉-触觉感知中解决长程任务。它首先在通用物体重摆任务上预训练一个灵巧策略,然后在下游任务中利用这个预训练行为作为先验进行后训练。
这种方法让多指机器人能够学会那些从零开始很难发现的新行为,同时避免为每个下游任务都重新学习同一套技能。预训练策略可以零样本完成下游任务的重摆阶段,但简单直接的强化学习微调会迅速破坏这一能力。
为此,研究者提出了一种稳定的后训练配方,结合行为克隆蒸馏、critic 热身和保守的 on-policy 更新。为了安全地利用完整的运动学灵巧性,他们还引入了关节空间几何织物(joint-space Geometric Fabric),在强化学习策略与机器人之间进行协调。
后训练的教师策略被蒸馏为感知型学生策略,并在两个机器人本体上实现零样本 sim-to-real 迁移:一个是配备两个 RGB 相机的 23 DoF Kuka-Allegro,另一个是配备两个 RGB 相机和五个视觉触觉传感器的 29 DoF Flexiv-Sharpa。实验表明,这些策略能够从具有挑战性的初始状态以接近人类速度完成长程任务。