FetchMan:从模拟经验学习人形机器人视觉运动操作策略
原标题:FetchMan: Learning Visual Humanoid Loco-Manipulation Policies from Simulated Experiences
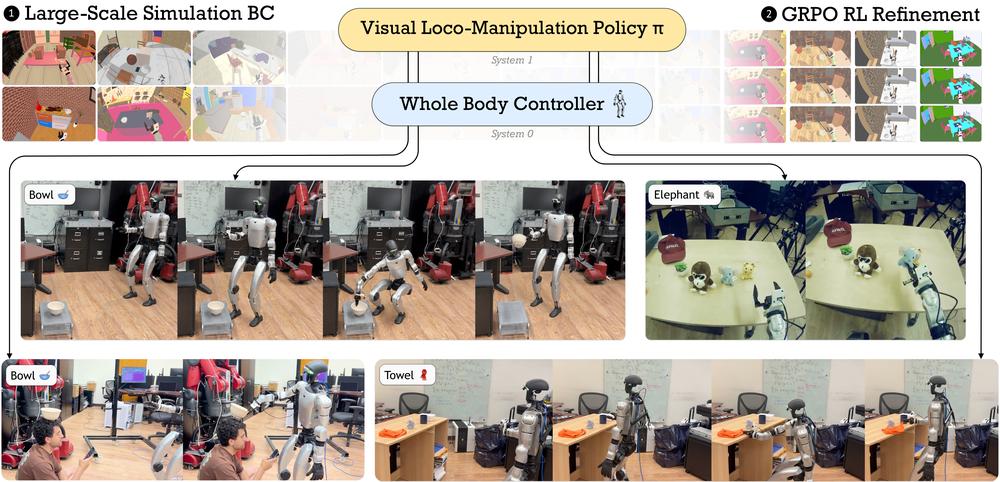
能够泛化到新场景与新物体的视觉运动操作(loco-manipulation)策略,一直是机器人研究追求的目标。然而,如今对数据贪婪的算法让收集足够演示本身就十分困难——对桌面操作尚且如此,对必须同时行走和保持平衡的人形机器人来说更是难上加难。
从仿真数据学习再将行为迁移到真实世界——正如运动(locomotion)领域常见做法——绕开了这一难题,因此研究者将该配方复制到运动操作任务上。在此过程中他们发现,无论训练数据有多少,克隆合成演示都会导致较低的性能上限。强化学习突破了这一瓶颈:用单一稀疏奖励对克隆策略进行 Flow-GRPO 微调,其性能远超合成行为克隆。
这些阶段共同构成了端到端的 sim-to-real 管线,覆盖超过 15 万个场景,研究者用它训练出 FetchMan。他们在发布的仿真基准 FetchMan-Bench 上进行评估,并将其零样本部署到真实的 Unitree G1 上:单目标抓取策略能够在未见场景中步行接近并抓取目标,成功率 73.3%。最后,他们将这一配方扩展到多目标训练,向着这一数据规模下运动操作通用策略迈出了第一步。