GWM-VLA:面向视觉-语言-动作学习的几何感知潜在世界建模
原标题:GWM-VLA: Geometry-Aware Latent World Modeling for Vision-Language-Action Learning
(GWM-VLA:面向视觉-语言-动作学习的几何感知潜在世界建模)
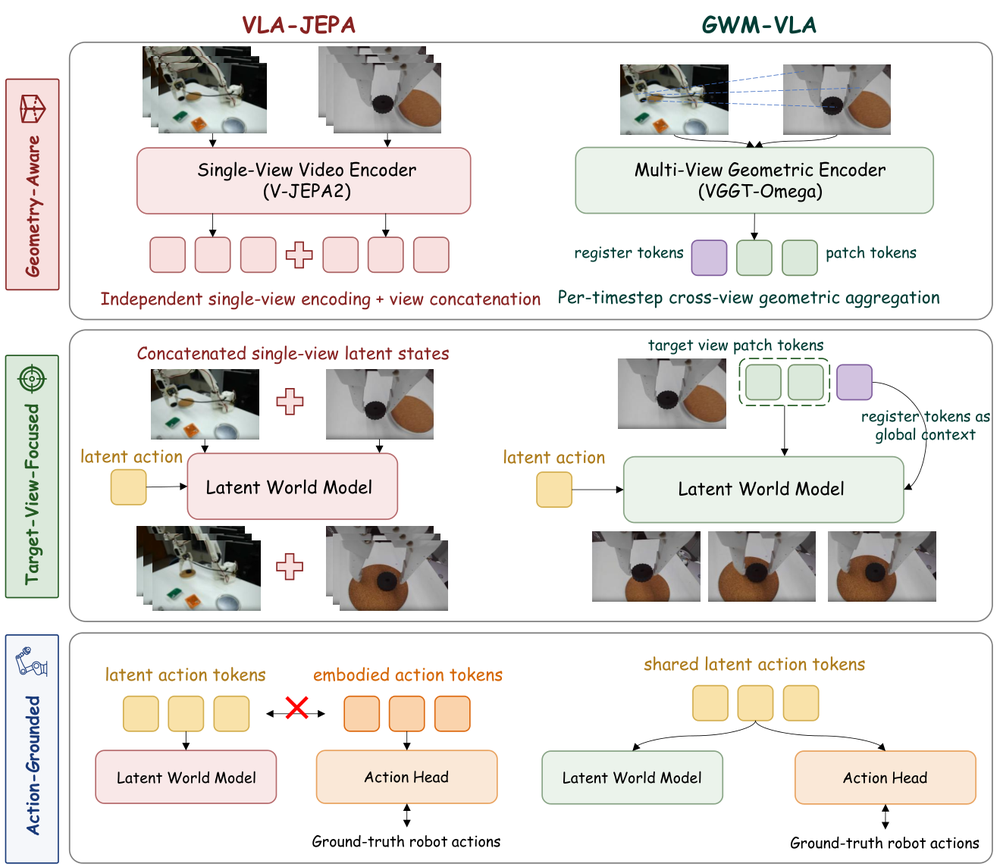
arXiv:2608.07619v1 公告类型:新发布 摘要:Vision-Language-Action(VLA)模型在机器人操作上取得了出色的性能,但在视觉和环境变化下往往会出现性能退化。潜在世界建模(latent world modeling)为提升鲁棒性提供了一种有前景的方法,但现有方法通常独立编码各相机视角,并在不显式建模其几何关系的情况下预测整体场景动态。我们提出了 GWM-VLA,一个面向 VLA 学习的几何感知潜在世界建模框架。GWM-VLA 结合了几何感知的多视角状态编码、以全局上下文为条件的目标视角预测,以及由机器人动作监督所锚定的共享潜在动作表征。具体来说,VGGT-$\Omega$ 在每个时间步联合聚合多视角观测,以构建几何感知的多视角状态。该潜在世界模型利用多视角聚合后得到的 patch token 和 register token,预测所选目标视角下一时间步的 patch token,从而在无需预测完整多视角状态的情况下保留多视角几何信息。我们在实验中以腕部视角作为目标视角,更加强调末端执行器(end effector)运动以及局部的夹爪-物体交互。最后,共享的潜在动作表征同时作为潜在世界模型和 flow-matching 动作头的条件,使潜在预测监督与真实机器人动作监督能够共同塑造同一套潜在动作表征。在仿真和真实环境中的实验均证明了 GWM-VLA 的有效性和鲁棒性。