ForeTime-VLA:从世界动作模型蒸馏因果未来 Token,用于传送带动态抓取
原标题:ForeTime-VLA: Causal Future-Token Distillation from a World Action Model for Conveyor-Belt Manipulation
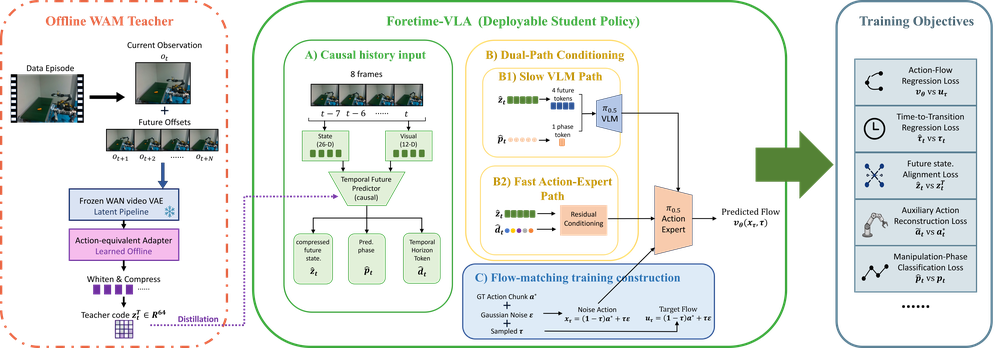
操控运动中的物体要求策略能够预判接触事件,但现有的视觉-语言-动作(VLA)策略通常仅基于当前观测进行微调。世界动作模型(World Action Models, WAM)可以学习预测性动力学,但在部署时运行视频级教师模型或显式想象未来帧成本高昂。
本文提出 ForeTime-VLA,一种密集的 pi0.5 策略,它从一个冻结的 Fast-WAM 教师模型中蒸馏出具有未来感知能力的动作等价表征,同时在推理时保持因果性。
离线阶段,当前与未来视频隐变量被压缩到一个白化的 64 维目标向量中。在线阶段,一个八帧历史编码器同时预测该目标、操作阶段以及归一化的过渡时间。四个未来 token 与一个阶段 token 用于条件化 VLM 前缀,而预测的未来与过渡范围则条件化动作专家。训练保留了原始的流匹配动作目标,并增加了余弦、关系几何、阶段、过渡时间与动作等价性等辅助目标。
在一个去重的传送带数据集上,研究者在每个划分 768 个匹配窗口上比较了 40k 步检查点。测试 MAE 从 0.134119 降至 0.130593(提升 2.63%;成对自助 95% 置信区间 0.82-4.48%),测试 L2 下降 3.02%,延迟成本仅增加 2.46-2.93%。
在真实机器人定量评估中,ForeTime-VLA 在静止物体上抓取成功率达 81.1%,在慢速移动物体上达 58.9%,分别超过次优基线 12.2 和 22.2 个百分点。在三种传送带速度下,它共完成 44/90 次抓取,而 pi0.5 仅完成 23/90;在快速带上为 11/30 对 2/30。离线方向增益与真实机器人接触姿态失败减少之间的一致性,支持了因果未来 Token 蒸馏能在不部署世界模型教师的情况下有效改善动态操作。