用自演示生成控制微调 VLA,实现多任务灵巧操作
原标题:Fine-Tuning VLAs with Self-Demonstrated Generative Control for Multi-Task Manipulation
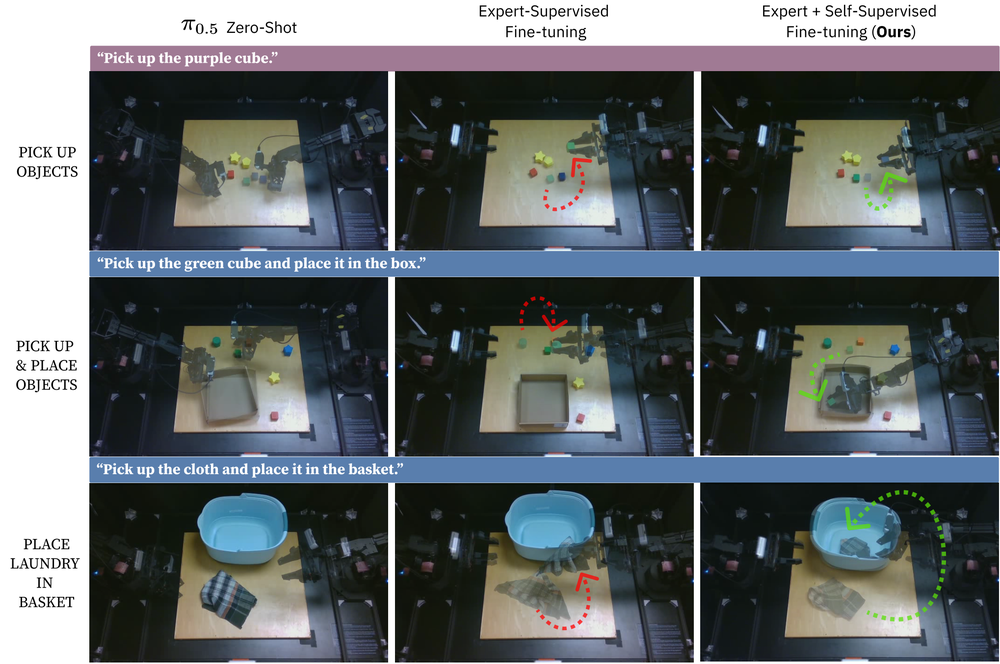
当前最先进的视觉-语言-动作(VLA)模型,如 π_0.5,具备强大的语义理解、指令遵循和任务执行能力。然而,当这些模型部署到新的机器人本体上时,即使硬件配置与预训练数据仅有微小不匹配,也可能导致性能严重下降。
直接在新的机器人本体上的专家数据上微调 VLA,可以提升其在专家任务上的表现,但会导致模型原有的指令遵循能力和行为先验丢失。
为此,研究者提出了一种自监督方法:从零样本 VLA 中在线生成交互轨迹,作为微调时的额外训练数据。实验表明,这种微调方案能够产生强大的多任务策略,在目标机器人上同时实现:(1)继承从零样本模型中蒸馏得到的先验任务能力;(2)保持通用指令遵循能力;(3)从专家数据中更高效地学习新技能。
研究者在真实 ALOHA 机器人以及新提出的 RoboTwin 仿真基准上验证了该方法,测试集涵盖了对泛化能力的多方面考察。相关视频结果已发布在 https://self-supervised-control.pages.dev/ 。