World Tokens:通过训练阶段的世界建模增强具身策略
原标题:World Tokens: Enhancing Embodied Policies with Training-Time World Modeling
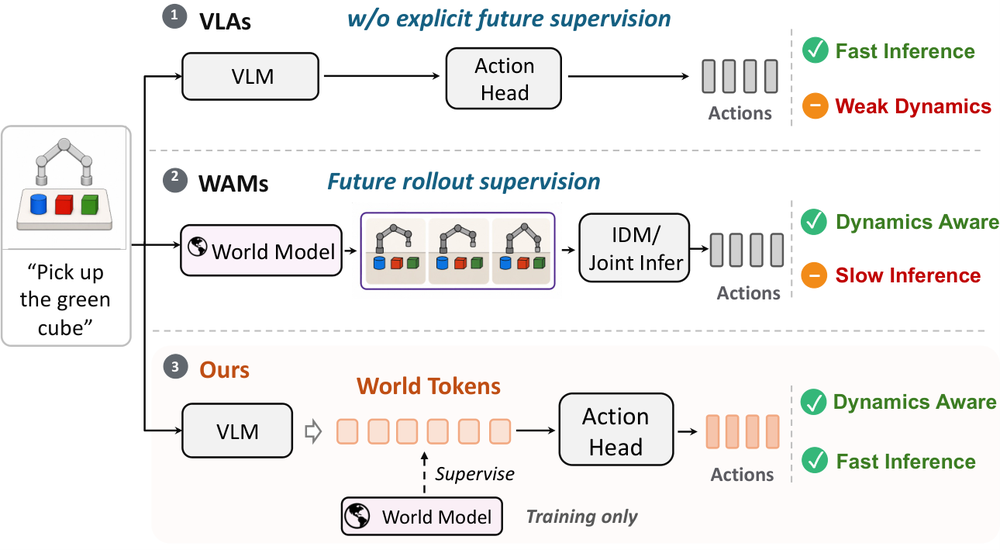
arXiv:2608.09730v1 公告类型:cross(跨领域提交)摘要:视觉-语言-动作模型(VLA)是具身策略中广泛采用的范式。它们擅长高效的闭环控制,但并未显式建模物理场景随任务推进的演化过程。近期兴起的世界-动作模型(WAM)利用预训练的视频世界模型来捕捉时空演化,但在控制回路中保留未来生成模块或大型视频骨干网络会大幅增加推理成本。我们提出 World Tokens,这是一种围绕 World Adapter 构建的具身策略架构,它在视觉-语言理解、世界动态建模与动作生成之间架起桥梁。它在训练阶段利用世界建模来增强动作策略,同时保持部署时的高效性。具体而言,World Adapter 将 VLM 特征转化为一组固定数量的 world token,这些 token 既作为联合微调的未来视频去噪器的条件,同时又是动作专家唯一的视觉-语言上下文。这种共享条件机制使得来自未来视频去噪的梯度能够直接塑造用于动作预测的表征,而独占式路由则防止策略绕过该表征。在部署时,世界模型分支被移除,仅保留 VLM、World Adapter 和动作专家,无需在线视频模型推理。凭借 2B 规模的骨干网络且未进行具身动作预训练,World Tokens 在 LIBERO 上表现极具竞争力,在 SIMPLER 上取得了目前已报告的最佳平均成绩,相比匹配的动作专用基线大幅提升了真实世界 R1 Pro 的成功率,并以 VLA 级别的延迟生成每个动作块(action chunk)。