STAR:面向灵巧操作的视觉-触觉-语言-动作模型中的稀疏触觉表征学习
原标题:STAR: Sparse Tactile Representation Learning in Vision-Tactile-Language-Action Models for Dexterous Manipulation
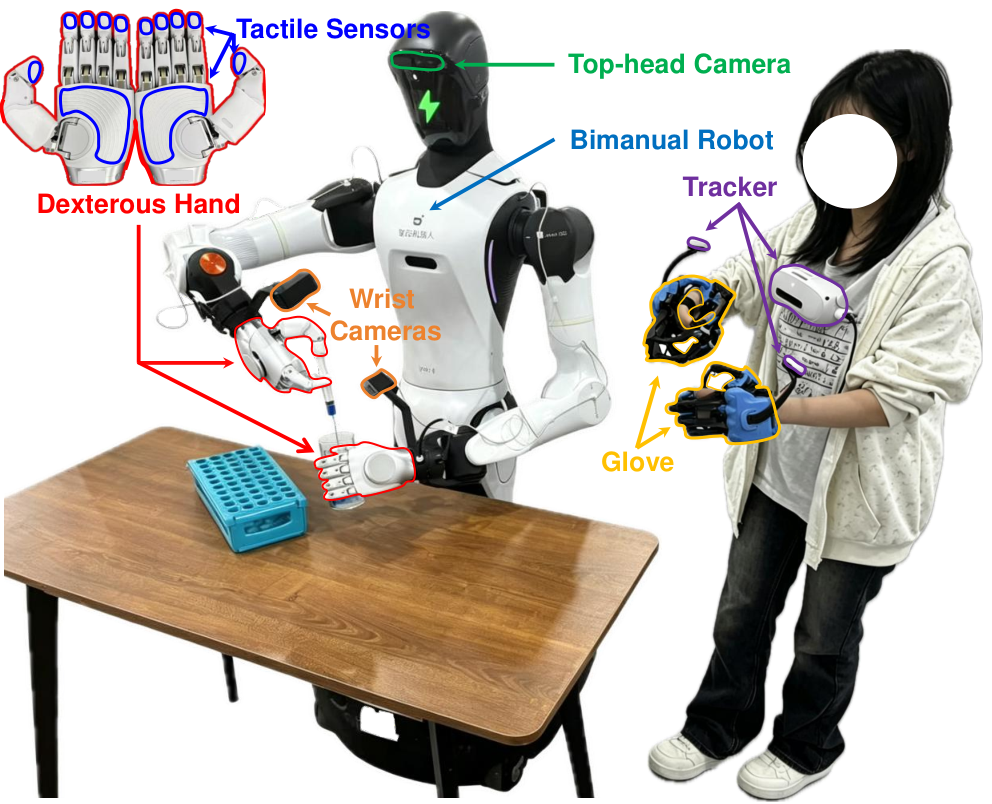
arXiv:2609.12549v1 公告类型:新发布 摘要:灵巧操作需要多指协同控制和有效的触觉反馈,然而由于大规模真实世界数据的缺乏,以及从稀疏触觉信号中提取有效表征的困难,学习这些能力仍然充满挑战。我们搭建了一个机器人平台和遥操作系统,采集了一个 200 小时的双臂灵巧操作数据集,包含同步的视觉、触觉和语言标注,共涵盖 65 项任务的 10,576 条轨迹,其中 69.5% 涉及多指灵巧操作。我们进一步提出了 STAR,一种面向视觉-触觉-语言-动作(VTLA)模型的集成训练方案,通过视觉-触觉联合预训练、稀疏-全局触觉 token 表征以及稀疏未来触觉预测,解决触觉信号在空间、时间和信息层面的稀疏性问题。在该数据集上训练后,STAR 在四项真实世界任务中、每项任务使用 100 条后训练轨迹的条件下,取得了 61% 的平均成功率,展示了在任务特定后训练下的灵巧操作性能。