Uni-VLaT:面向人形 Loco-Manipulation 的全身触觉 VLA 策略适配
原标题:Uni-VLaT: Whole-Body Tactile Adaptation of VLA Policies for Humanoid Loco-Manipulation
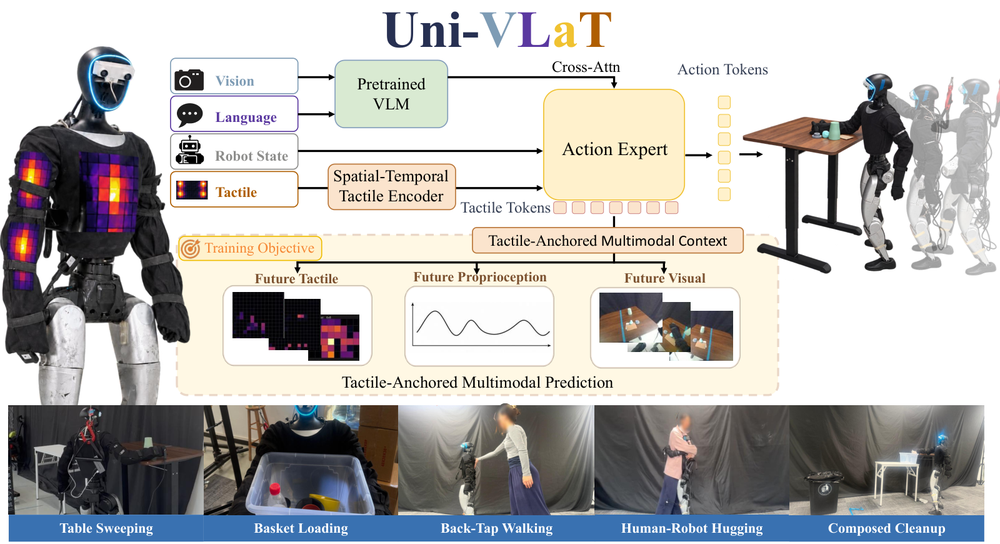
Uni-VLaT:面向人形 Loco-Manipulation 的全身触觉 VLA 策略适配
arXiv:2609.35450v1 公告类型:new 摘要:物理接触往往决定了人形机器人在 loco-manipulation 过程中应如何响应,然而仅凭视觉与本体感觉往往不足以表征物理交互,尤其是在接触区域被遮挡时。与预定义区域的稀疏力或力矩测量不同,分布式触觉感知能够保留机器人全身的空间分辨接触模式。因此,我们研究如何将这种全身触觉信息融入面向接触密集型控制的视觉-语言-动作(VLA)策略。我们的方法 Uni-VLaT 引入了一条触觉通路,其隐状态不仅用于动作生成,还用于预测未来的触觉、本体感觉与视觉表征。这一预测目标构建了以触觉锚定的多模态上下文,促进对物理世界更具结构化的理解。我们在五项真实机器人任务上评估 Uni-VLaT,涵盖触觉触发的运动、持续物理交互、人机接触以及 loco-manipulation。Uni-VLaT 平均成功率达 75%,比无触觉输入的基线高出 43 个百分点,比有触觉输入但无预测监督的基线高出 7 个百分点。在两种预训练 VLA 骨干网络下,我们的方法在 Table Sweeping 任务上均提升 30 个百分点,在 Back-Tap Walking 任务上提升 85-90 个百分点。消融实验进一步表明,上下文化的触觉预测与绝对未来目标是性能关键。这些结果表明,预测性触觉学习为将预训练 VLA 策略扩展至全身物理交互提供了一条有效途径。