ω-0:用于人形机器人并行移动操作的潜在预测世界-动作模型
原标题:$\omega$-0: A Latent Predictive World Action Model for Concurrent Humanoid Loco-Manipulation
arXiv:2608.06375v1 公告类型:新发布
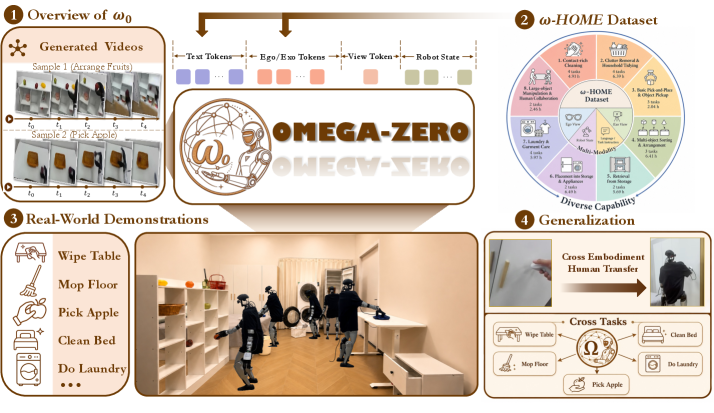
摘要:人形机器人的家庭任务通常需要并发的移动-操作(concurrent loco-manipulation),即机器人必须将移动、姿态调整、平衡维持与物体操作为一个统一协调的行为来完成。然而,现有的人形机器人策略通常将行走(locomotion)与操作(manipulation)分解处理,而近期的世界-动作模型(world-action model)则要么以机械臂为中心,要么以视频为中心。我们提出了 $\omega$-0,一个面向真实世界人形机器人并发移动-操作的隐空间预测全身世界-动作模型。给定语言指令、当前视觉观测和机器人本体感知状态,$\omega$-0 直接预测与控制器兼容的全身动作隐变量(action latents),用于真实机器人执行。$\omega$-0 并不重建未来视频,而是学习紧凑的未来观测嵌入,以此作为轻量化的预测目标,将隐空间视觉前瞻与基于扩散(diffusion)的全身动作生成相耦合。该模型支持第一视角(egocentric)RGB、第三视角(exocentric)RGB 以及第三视角深度输入,并利用基于控制器的仿真回放,将人类/公开的视觉-运动先验落地为机器人可执行的动作隐变量。我们进一步采集了 $\omega$-HOME,一个超过 40 小时的真实世界家庭人形机器人数据集,包含同步的多视角观测、全身 SMPL 动作、机器人状态和动作隐变量。在 11 项家庭任务上的真实世界实验表明,单个 $\omega$-0 模型即可产生流畅的"边移动边操作"行为,并持续优于代表性的模仿学习、VLA、人形机器人和 WAM 基线方法。