DeCAL:通过接触感知潜在共想象构建物理落地的灵巧视觉-语言-动作(VLA)模型
原标题:DeCAL: Towards Physically-Grounded Dexterous Vision-Language-Action Models via Contact-Aware Latent Co-Imagination
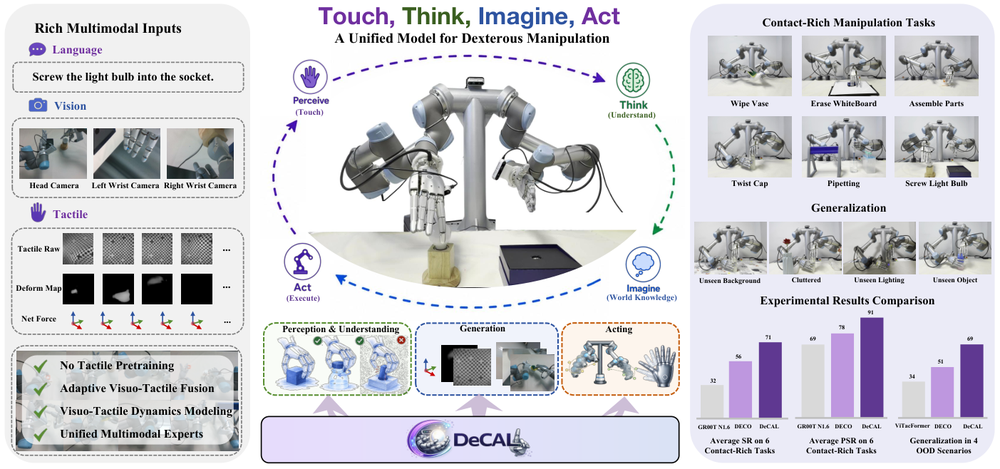
arXiv:2609.09119v1 公告类型:新发布 摘要:灵巧操作涉及与物理世界的富接触、细粒度交互,由于严重的视觉遮挡和复杂的接触动力学,对现有的视觉-语言-动作(VLA)模型构成了重大挑战。尽管近期的工作已将触觉感知引入机器人操作中,但大多数方法仍依赖于同质化的多模态融合,缺乏自适应的触觉信息整合能力以及对物理动力学的显式建模。在这项工作中,我们提出了 DeCAL,一种物理接地的灵巧视觉-语言-动作模型,将理解、想象和动作生成统一起来,用于富接触的灵巧操作。DeCAL 构建于 Mixture-of-Transformers(MoT)架构之上,为每种能力配备了专门的专家模块,同时支持它们之间高效的信息流动。为了有效利用触觉信息,我们引入了自适应视觉-触觉融合(Adaptive Visuo-Tactile Fusion),通过接触感知门控策略动态调节触觉交互。此外,我们提出了视觉-触觉潜空间协同想象(Visuo-Tactile Latent Co-Imagination),对视觉和触觉动力学进行联合建模,使机器人策略具备隐式的物理世界知识。实验结果表明,DeCAL 在所有任务上均持续取得最先进的性能,平均成功率达到 71%,进度成功率达到 83.4%,同时还展现出对未见场景的强泛化能力。项目网站:https://aureleopku.github.io/DeCAL。