Veo-Act:用前沿视频生成模型增强 VLA 策略
原标题:Veo-Act: Enhancing VLA Policies with Frontier Video Models
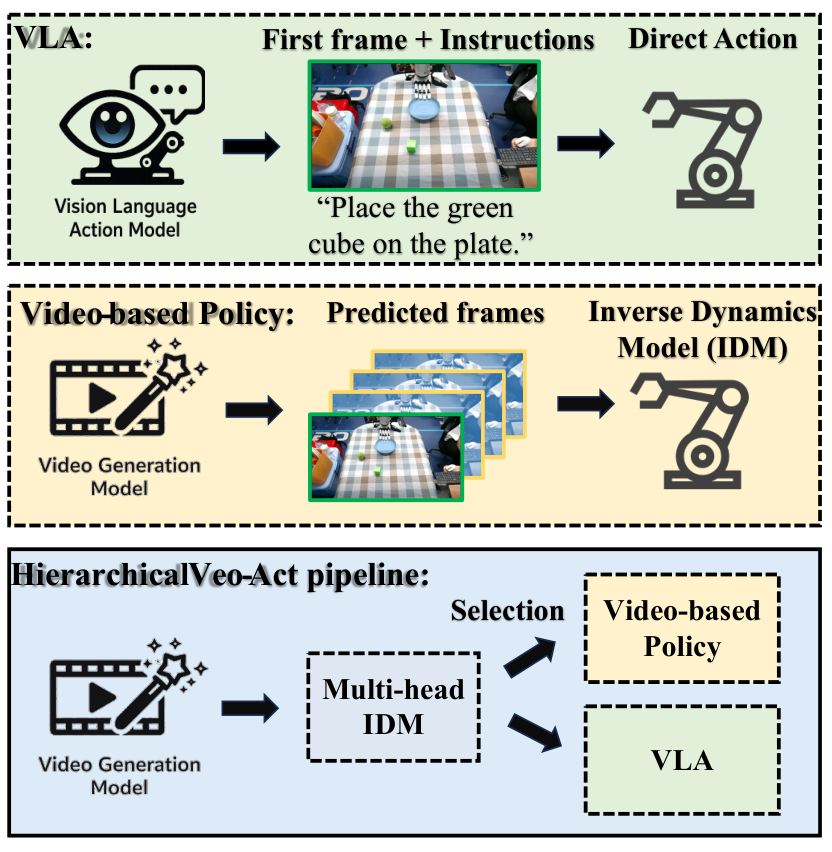
视频生成模型能够产生连贯的视觉序列,描绘物体运动和交互。本研究探索前沿视频生成模型如何补充 vision-language-action(VLA)策略,以增强可泛化的机器人操作。
VLA 策略已成为机器人学习的主流范式,但将预训练 VLM 动作化(action-oriented adaptation)的改造方式会削弱语义泛化能力,在模糊或分布外(out-of-distribution)操作场景中鲁棒性有限。研究者使用视频模型作为视觉规划器,动机在于它们在复杂场景中的泛化潜力以及对手部运动的先验知识。
然而,基于视频模型的操作方法往往缺乏低级灵巧交互所需的精度和时间响应性。为此,本研究提出 Veo-Act:一个分层框架,以 Veo-3.1 作为高层运动规划器,VLA 策略作为低层执行器。一个多头逆动力学模型将生成的帧对转换为动作,并学习一个交互门控(interaction gate)来触发向反应式 VLA 控制的交接。
在仿真和真实机器人上的实验表明,与基线 VLA 相比,Veo-Act 在新颖且语义复杂的操作设置中改善了指令遵循能力和整体任务成功率,支持了视频规划与反应式交互互补作用的观点。